Introduction — Une question simple qui cache une complexité
Vous demandez à une IA : « Pourquoi certaines odeurs nous rappellent-elles notre enfance ? »
La réponse apparaît quelques secondes plus tard. Elle semble fluide. Cohérente. Pertinente. Vous lisez des explications sur la mémoire, sur le cerveau, sur le fonctionnement sensoriel. Tout cela semble cohésif, comme si une personne réfléchie avait composé une réponse à votre intention.
Mais qu’y a-t-il réellement entre le moment où vous appuyez sur « Envoyer » et celui où la réponse s’affiche ? Qu’est-ce qui transforme votre question en cette succession de mots apparemment pensée ?
Ce qui se passe entre ces deux moments n’est ni magique ni trivial. C’est une cascade de transformations : votre question est d’abord traduite, puis traitée selon des mécanismes qu’un modèle a appris à travers des mois d’entraînement, puis une réponse est progressivement générée. À chaque étape, des choix statistiques sont faits. À chaque étape, des limites qui ne sont pas toujours visibles façonnent ce que vous recevez.
Comprendre ce parcours, c’est acquérir une forme de littéracie fondamentale pour notre époque.
Les tokens — La traduction invisible de votre question
Quand vous tapez votre question, vous écrivez en français : « Pourquoi certaines odeurs nous rappellent-elles notre enfance ? »
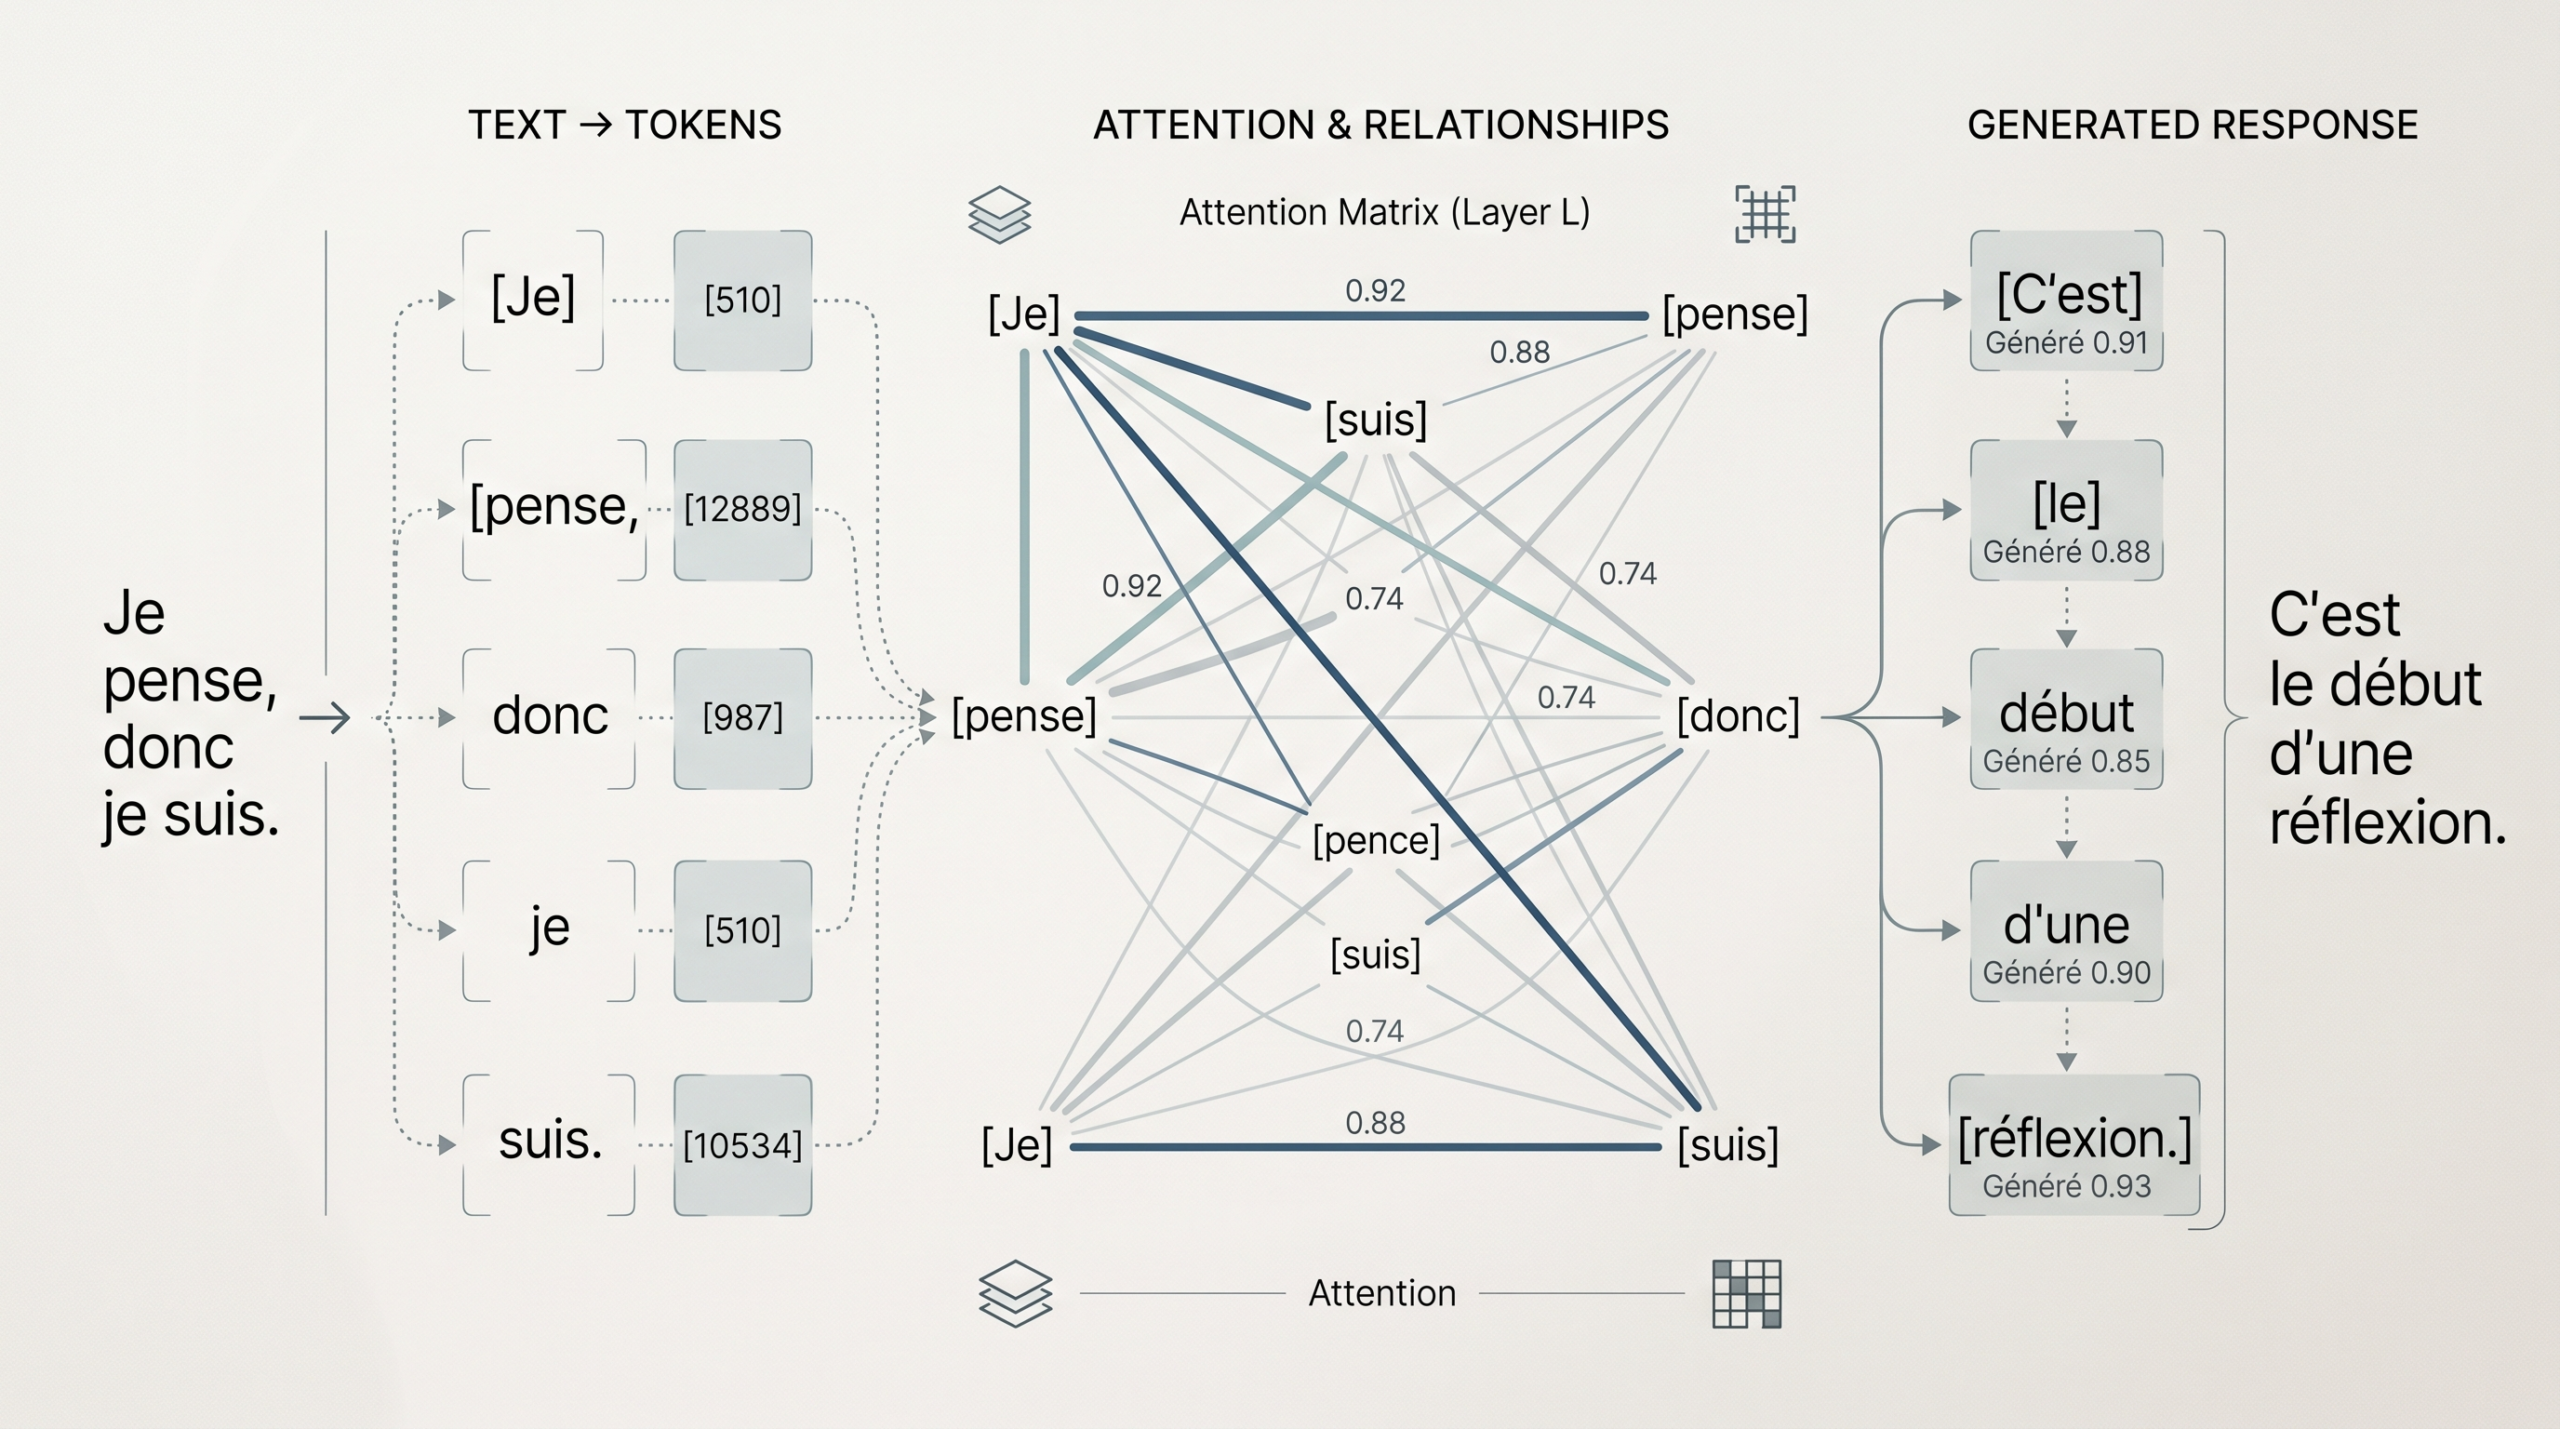
Ce que vous envoyez au modèle n’est pas directement ce texte. Il est d’abord transformé en unités appelées tokens. Un token n’est pas nécessairement un mot. En français, le mot « aujourd’hui » pourrait être un seul token, tandis que « l’automatisation » se diviserait en plusieurs. Les ponctuations, les espaces, les terminaisons : tout est tokenisé d’une manière spécifique au modèle utilisé.
Ces tokens deviennent ensuite des nombres. Chaque token reçoit une identité numérique que le modèle peut manipuler. Votre question n’est plus du texte. C’est une séquence de représentations numériques.
Cette transformation semble triviale, mais elle est fondamentale. Elle signifie que le modèle ne lit pas votre question comme vous la lisez. Il en extrait une structure numérique qu’il peut traiter selon les mécanismes appris durant son entraînement.
Le contexte — Votre question n’arrive jamais seule
Votre question n’arrive jamais au modèle isolée. Selon le système utilisé, le contexte peut inclure la conversation précédente, les instructions systèmes que l’équipe a fournies au modèle, ou les exemples que vous avez pu inclure dans votre requête. Toutes ces informations forment un arrière-plan sur lequel votre question s’inscrit.
Logiquement, on pourrait supposer que davantage de contexte améliore nécessairement la réponse. Or, une étude récente de Liu et ses collègues (2024) montre que ce n’est pas systématiquement le cas. Les modèles n’utilisent pas uniformément toutes les informations qui leur sont fournies. Certaines parties du contexte sont mieux exploitées que d’autres. Parfois, des informations positionnées au milieu d’un long contexte sont sous-utilisées — un phénomène que les chercheurs appellent prudemment « Lost in the Middle ».
Cela soulève une question pratique : fournir plus de contexte ne suffit pas. C’est la pertinence et la structure du contexte qui compte.
L’attention — Comment les tokens établissent des relations
Une fois tokenisée et contextualisée, votre question doit être traitée. C’est ici qu’intervient un mécanisme appelé attention, au cœur de l’architecture Transformer.
L’architecture Transformer a été introduite en 2017 par Vaswani et ses collègues. Son innovation clé est le mécanisme d’attention, qui permet au modèle de calculer les relations entre les différents tokens d’une séquence.
Imaginons votre question tokenisée. Le mécanisme d’attention calcule comment chaque token se « relate » aux autres. Quel est le lien entre « odeurs » et « enfance » ? Entre « rappellent » et « sensoriel » ? Ces relations ne sont pas codées explicitement. Elles sont calculées dynamiquement à partir des poids que le modèle a appris pendant son entraînement.
Cela permet au modèle de construire une compréhension contextuelle : « enfance » dans cette phrase n’est pas un mot isolé, mais un concept relié à « odeurs », à la mémoire, aux sens. Le mécanisme d’attention établit ces connexions rapidement et en parallèle, pas séquentiellement comme vous pourriez lire une phrase mot après mot.
Il faut préciser : ce n’est pas une « compréhension » au sens humain. C’est un calcul probabiliste de relations entre représentations numériques. Mais ce calcul génère des résultats qui ressemblent étrangement à ce que produirait une compréhension.
L’entraînement — D’où viennent ces capacités ?
Avant même que vous posiez votre question, des mois de travail se sont écoulés. Le modèle a d’abord été entraîné sur des quantités massives de texte provenant d’Internet, de livres, d’articles. Cet apprentissage initial, qu’on appelle pré-entraînement, lui permet d’apprendre les régularités statistiques du langage : comment les mots s’associent, quels contextes suivent certains tokens, quelles structures résument, expliquent ou illustrent des idées.
Mais le pré-entraînement seul ne suffit pas. Après ce premier apprentissage, le modèle subit un post-entraînement. C’est ici que des chercheurs humains interviennent pour affiner son comportement. Selon Ouyang et ses collègues (2022), cette phase s’appelle Reinforcement Learning from Human Feedback (RLHF). Des humains évaluent les réponses du modèle, indiquent lesquelles sont pertinentes, honnêtes, utiles. Le modèle ajuste ses poids pour imiter ce retour.
Cette étape change profondément comment le modèle formule ses réponses. Elle ne lui enseigne pas des faits nouveaux — le modèle connaît déjà beaucoup de choses du pré-entraînement. Elle le rend simplement meilleur pour répondre aux questions de manière pertinente et structurée.
Personne n’a explicitement programmé au modèle : « Voici la relation entre odeurs et mémoire autobiographique ». Le modèle l’a appris statistiquement par exposition et par feedback. Les capacités qui émergent de cette mécanique peuvent sembler sophistiquées, mais elles proviennent d’ajustements statistiques, pas d’une compréhension explicitement encodée.
📬 NDIYAM Newsletter
Cet article vous plaît ? Recevez nos prochaines explorations directement par e-mail, une fois par semaine — et un guide en cadeau de bienvenue.
La génération — Comment votre réponse se construit progressivement
Maintenant que votre question a été tokenisée, contextualisée, et que le modèle a activé ses mécanismes d’attention en fonction de son entraînement, il peut générer une réponse.
Contrairement à ce qu’on pourrait imaginer, le modèle ne « cherche » pas une réponse préexistante dans quelque base de données. Il la génère progressivement, token après token. À chaque étape, le modèle produit une distribution de probabilités : quel est le prochain token le plus susceptible de suivre ce que j’ai généré jusqu’à présent ?
Cette génération progressive est à la fois puissante et contrainte. Elle permet une flexibilité remarquable — la réponse peut prendre des formes diverses selon la configuration du modèle. Mais elle crée aussi une limite fondamentale : le modèle génère ce qui est statistiquement probable, pas nécessairement ce qui est vrai.
Une question que posent souvent les chercheurs : peut-on améliorer les performances en demandant au modèle de « montrer ses étapes intermédiaires » ? Wei et ses collègues (2022) ont exploré cela avec ce qu’on appelle le « chain-of-thought prompting ». Résultat : dans certaines tâches, demander au modèle de dérouler son raisonnement améliore effectivement les performances. Mais cela ne signifie pas que le modèle « raisonne » au sens humain. Cela signifie simplement que cette formulation des instructions améliore certaines performances dans certains contextes. Une distinction importante.
Les limites — Une réponse fluide n’est pas une garantie de vérité
Voici le cœur du problème : la qualité apparente d’une réponse n’est pas une preuve de sa véracité.
Un modèle entraîné à générer du texte fluide et convaincant ne dispose d’aucun mécanisme interne pour vérifier la vérité de ce qu’il produit. Il optimise pour la plausibilité, la pertinence stylistique, la cohérence apparente — pas pour l’exactitude factuelle.
Cela peut produire plusieurs types d’erreurs : des erreurs factuelles évidentes ; des réponses plausibles mais factuellement inexactes, difficiles à détecter sans vérification ; des erreurs subtiles de raisonnement ou de logique ; des réponses confiantes sur des sujets où le modèle manque de données fiables.
La littérature scientifique a développé le terme d’« hallucination » pour décrire ces erreurs. Mais il faut préciser : ce terme recouvre différentes réalités selon les chercheurs. Venkit et ses collègues (2024) ont audité 103 publications scientifiques sur le sujet. Leur conclusion : il n’existe pas une définition unique et universellement stabilisée de ce qu’est une « hallucination » en IA générative. Les chercheurs débattent encore des catégories pertinentes, des méthodes d’évaluation, des seuils pour identifier le phénomène.
Zhang et ses collègues (2025) offrent une synthèse récente. Selon eux, les hallucinations peuvent être extrinsèques (le modèle invente des faits inexacts) ou intrinsèques (le modèle génère quelque chose qui contredit ses propres énoncés précédents). Mais la question de savoir comment les détecter, les réduire et les définir précisément reste ouverte.
Il y a aussi les limites du contexte, que nous avons abordées. Un long contexte ne garantit pas une meilleure exploitation des informations. Et il y a les limites plus générales : un modèle n’« apprend » pas continuellement. Ses connaissances propres s’arrêtent à une certaine date. Beaucoup d’assistants peuvent aujourd’hui effectuer des recherches en ligne ou consulter des documents pour compléter ces connaissances — mais cela ne règle pas tout : ils peuvent retenir des sources peu fiables, les résumer de travers, ou mêler ce qu’ils ont trouvé à ce qu’ils « croient savoir ». Une réponse accompagnée de liens n’est pas, en soi, une réponse vérifiée.
La gestion de ces risques est maintenant considérée comme un domaine en soi. Le NIST (National Institute of Standards and Technology) a publié en 2024 un cadre pour la gestion des risques liés à l’IA générative. Le constat central : il faut accepter qu’un certain niveau de risque existe et le gérer plutôt que de chercher à l’éliminer complètement.
La vérification — Le rôle qui reste humain
Cela nous ramène à vous : le lecteur, l’utilisateur, la personne qui pose la question.
Une fois la réponse affichée, la responsabilité revient à vous. Trois compétences deviennent alors critiques :
Bien questionner. La qualité de la réponse dépend en partie de la qualité de la question. Une demande vague produira des réponses vagues ou erratiques. Une demande précise, bien contextualisée, avec les détails pertinents, favorise une réponse plus adaptée. Apprendre à formuler des questions claires est en soi une forme d’art.
Bien contextualiser. Fournir le bon contexte au modèle — les informations préalables pertinentes, les exemples d’attentes — peut améliorer le résultat. Mais comme nous l’avons vu, la quantité de contexte ne compte pas autant que sa qualité et sa pertinence. Savoir ce qu’il est utile de partager est une compétence.
Bien vérifier. Quand l’exactitude compte — et elle compte souvent —, une réponse convaincante doit être confrontée à des sources, des données, des faits vérifiables. C’est le travail humain par excellence. Aucun modèle ne peut vous l’épargner.
Ces trois éléments forment une boucle : questionner mieux → contextualiser mieux → vérifier mieux. À mesure que les systèmes d’IA deviennent plus capables de produire des réponses persuasives, notre capacité à les questionner, les contextualiser et les vérifier devient plus critique, pas moins.
Conclusion — Comprendre pour mieux questionner
Revenons à votre question initiale : « Pourquoi certaines odeurs nous rappellent-elles notre enfance ? »
Entre l’envoi et la réponse, il y a eu une transformation. Votre texte en français a été converti en tokens numériques. Ces tokens ont été traités par un réseau de mécanismes d’attention calculant les relations entre eux. Le modèle a puisé dans ce qu’il avait appris lors de son pré-entraînement et de son post-entraînement. Il a généré progressivement une réponse, chaque nouveau token sélectionné selon les probabilités apprises.
Cette réponse peut être remarquablement pertinente et bien formulée. Mais elle n’est pas une garantie de vérité. Elle est une prédiction statistique, sophistiquée mais statistique.
Comprendre ce processus ne détruit pas la magie. Il la remplace par quelque chose de plus intéressant : une compréhension de comment ces systèmes fonctionnent réellement, de leurs capacités réelles, de leurs limites véritables.
Et c’est avec cette compréhension que vous êtes mieux armé pour travailler avec l’IA : poser de meilleures questions, fournir de meilleur contexte, vérifier davantage rigoureusement. Parce que, in fine, plus les machines deviennent capables, plus notre discernement devient précieux.
Sources et références
Sources académiques primaires
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). « Attention Is All You Need. » Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 5998–6008. https://arxiv.org/abs/1706.03762
Brown, T. B., Mann, B., Ryder, N., et al. (2020). « Language Models are Few-Shot Learners. » Advances in Neural Information Processing Systems 33 (NeurIPS 2020), 1877–1901. https://proceedings.neurips.cc/paper/2020/
Ouyang, L., Wu, J., Jiang, X., et al. (2022). « Training language models to follow instructions with human feedback. » Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/
Wei, J., Wang, X., Schuurmans, D., et al. (2022). « Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. » Advances in Neural Information Processing Systems 35 (NeurIPS 2022). DOI: 10.52202/068431-1800. https://proceedings.neurips.cc/paper/2022/
Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). « Lost in the Middle: How Language Models Use Long Contexts. » Transactions of the Association for Computational Linguistics, 12, 157–173. DOI: 10.1162/tacl_a_00638.
Revues et synthèses académiques
Venkit, P. N., Chakravorti, T., Gupta, V., Biggs, H., Srinath, M., Goswami, K., Rajtmajer, S., & Wilson, S. (2024). « An Audit on the Perspectives and Challenges of Hallucinations in NLP. » Proceedings of EMNLP 2024, 6528–6548. DOI: 10.18653/v1/2024.emnlp-main.375.
Zhang, Y., Li, Y., Cui, L., et al. (2025). « Siren’s Song in the AI Ocean: A Survey on Hallucination in Large Language Models. » Computational Linguistics, 51(4), 1373–1418. DOI: 10.1162/coli.a.16.
Sources institutionnelles
Autio, C., Schwartz, R., Dunietz, J., Jain, S., Stanley, M., Tabassi, E., Hall, P., & Roberts, K. (2024). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1. National Institute of Standards and Technology. DOI: 10.6028/NIST.AI.600-1.
Stanford Institute for Human-Centered Artificial Intelligence. (2026). The 2026 AI Index Report. Stanford University. https://hai.stanford.edu/ai-index/2026-ai-index-report
Source du concepteur
OpenAI. (2023). « GPT-4 Technical Report. » arXiv:2303.08774. https://arxiv.org/abs/2303.08774