En 2015, une chercheuse du MIT Media Lab installait une œuvre interactive utilisant un logiciel commercial d’analyse faciale. Le logiciel ne parvenait pas à détecter son visage. Il a fallu qu’elle tienne un masque blanc devant sa caméra pour que le système « voie » enfin un visage.
Cette chercheuse, Joy Buolamwini, aurait pu s’arrêter là, agacée par un bug. Elle a plutôt posé une question plus dérangeante : s’agissait-il vraiment d’un bug isolé, ou d’un problème plus large, présent dans des technologies que des millions de personnes utilisent chaque jour sans jamais y penser ?
INTRODUCTION
On imagine souvent les algorithmes comme des outils neutres — des calculs mathématiques, indifférents aux catégories humaines que sont la couleur de peau, le genre ou la langue maternelle. Cette neutralité supposée est l’une des idées reçues les plus tenaces de notre rapport à la technologie.
Elle est aussi, largement, une illusion. Un algorithme n’est jamais neutre : il reflète les données sur lesquelles il a été entraîné, et ces données reflètent les déséquilibres du monde qui les a produites. Quand ces déséquilibres ne sont pas corrigés, ils se retrouvent encodés — souvent de façon invisible — dans les outils que nous utilisons tous.
L’ÉTUDE QUI A RÉVÉLÉ L’AMPLEUR DU PROBLÈME
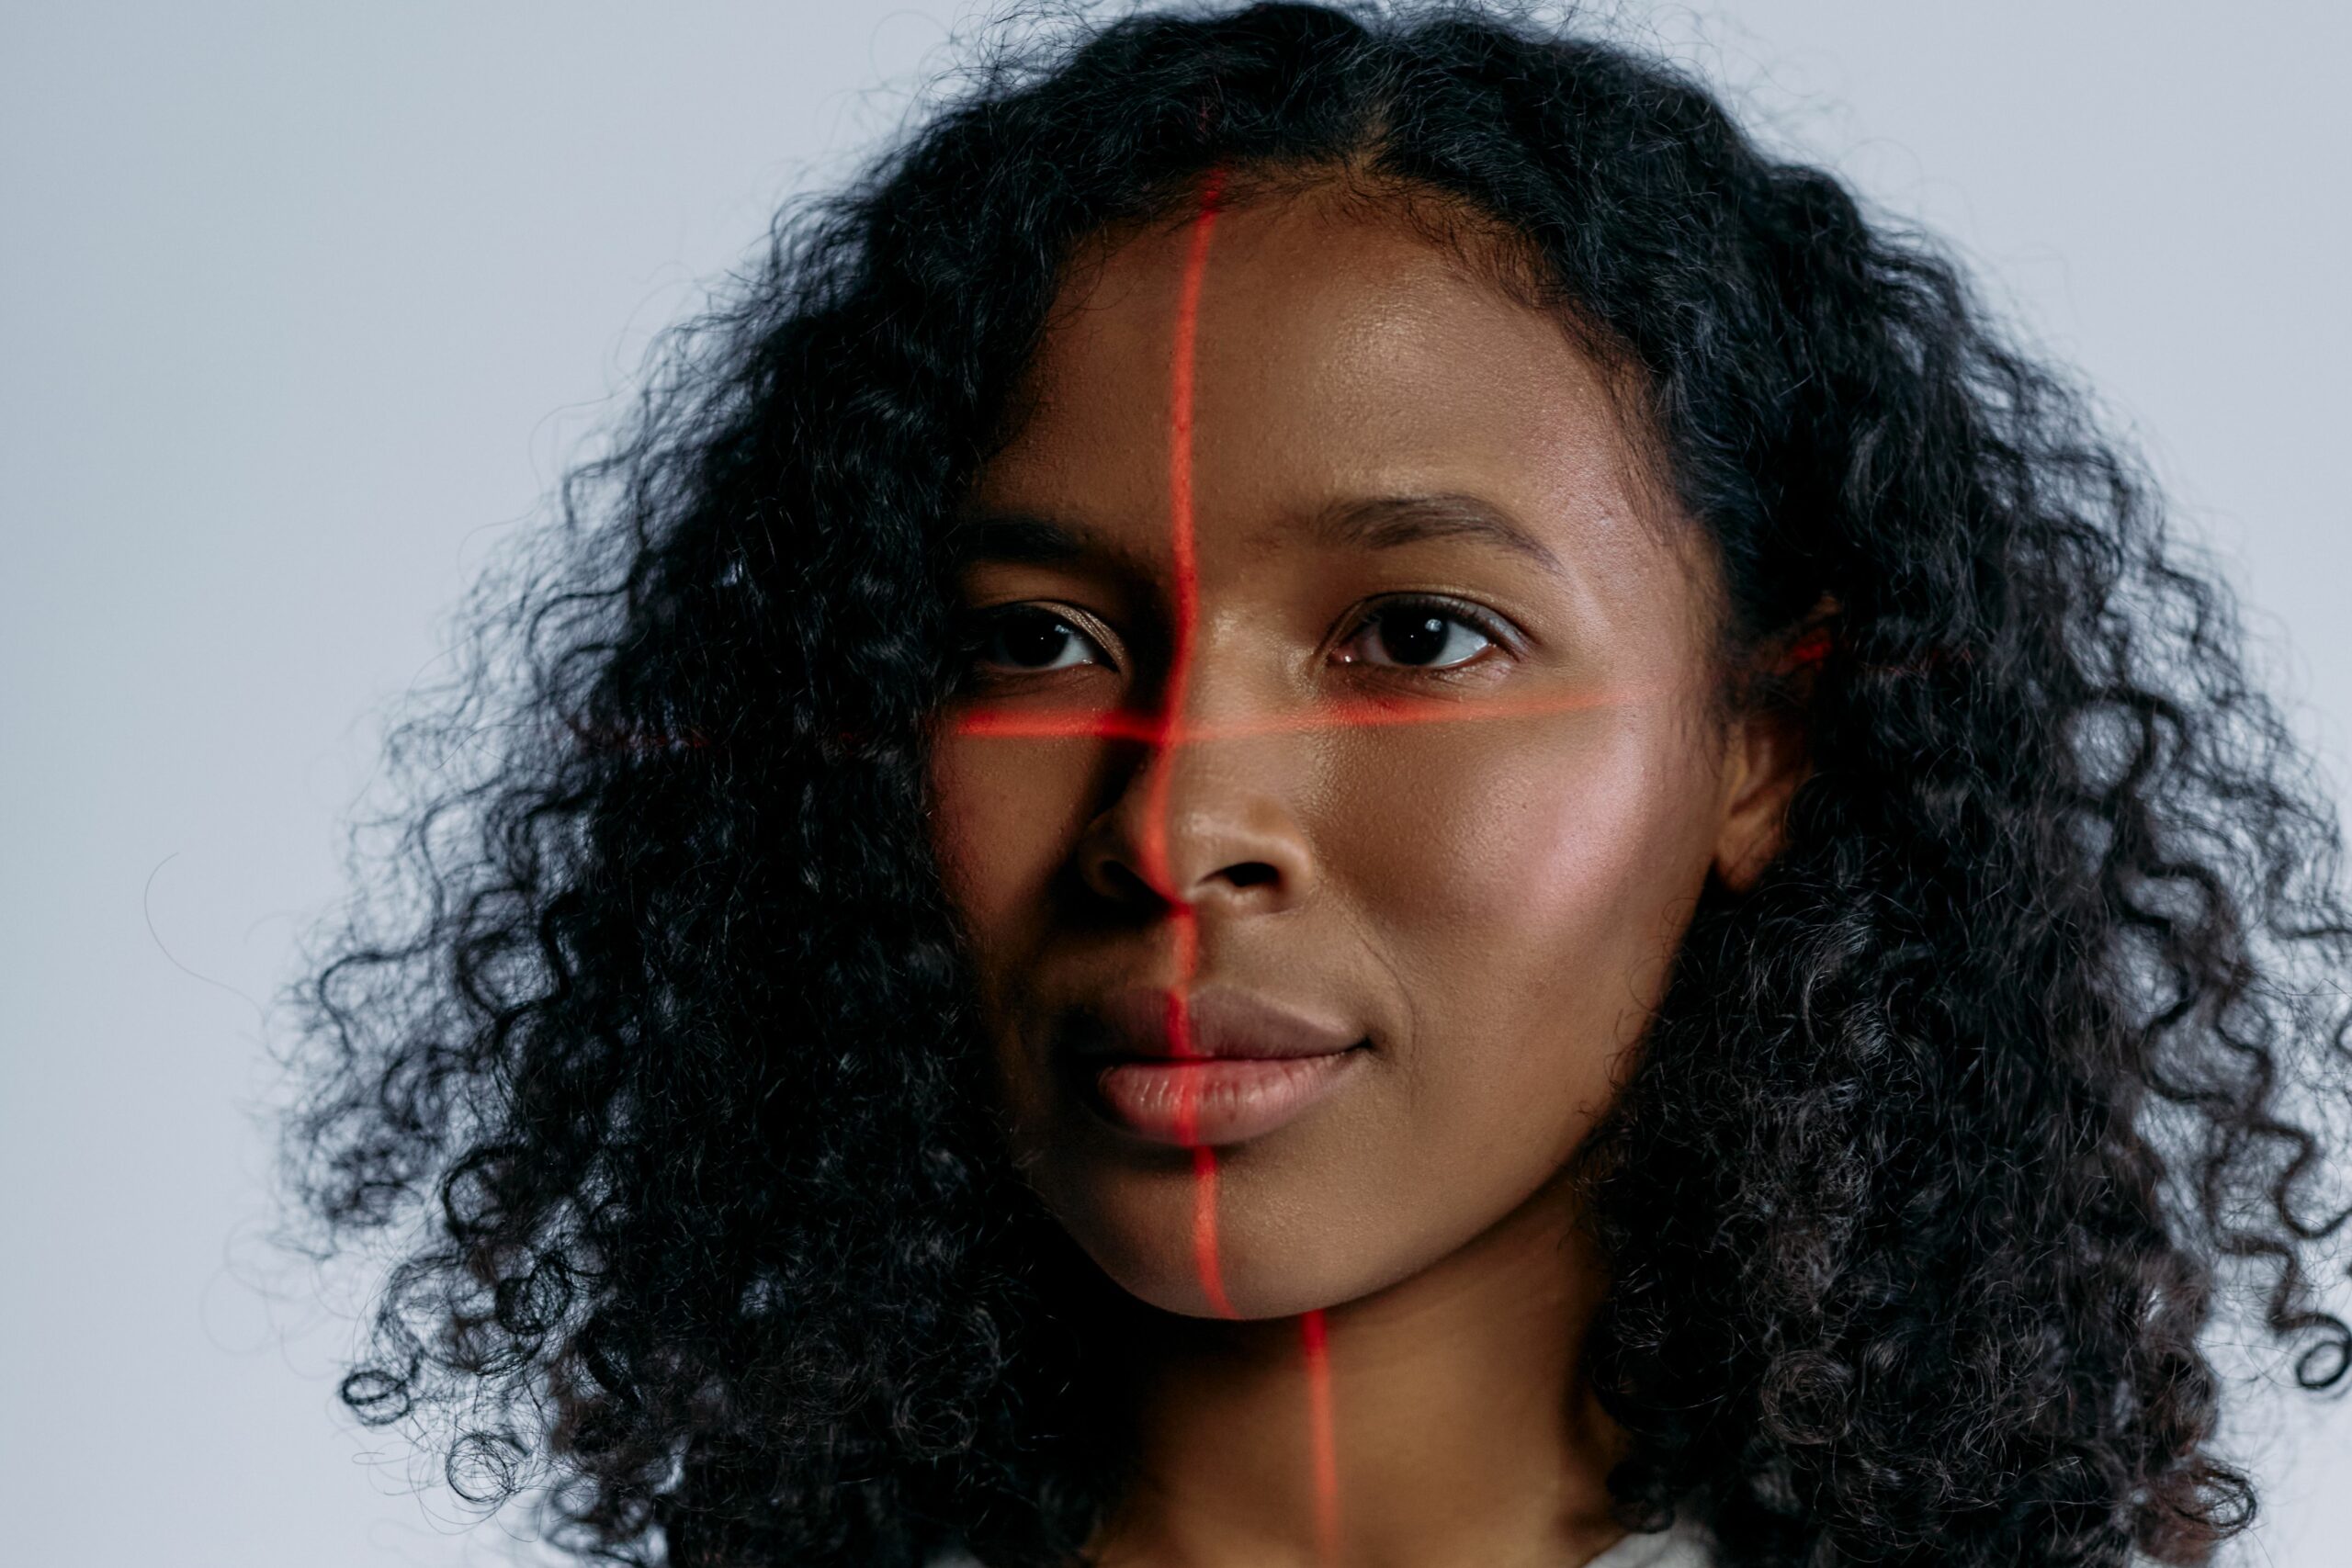
Poursuivant son intuition, Joy Buolamwini a mené, avec la chercheuse Timnit Gebru, une étude devenue une référence : Gender Shades, présentée en 2018 à la Conference on Fairness, Accountability, and Transparency. Elle a constitué un jeu de plus de 1 200 portraits, classés selon l’échelle de Fitzpatrick — un standard dermatologique de classification des tons de peau — puis testé trois systèmes commerciaux d’analyse faciale parmi les plus utilisés au monde.
Les résultats ont exposé un écart considérable. Pour les hommes à la peau claire, le taux d’erreur ne dépassait jamais 0,8 %. Pour les femmes à la peau foncée, ce taux grimpait entre 20,8 % et 34,7 % selon les systèmes. Pour les femmes à la peau la plus foncée sur l’échelle de Fitzpatrick, le taux d’erreur atteignait 46,5 % à 46,8 % — soit, comme le résume Buolamwini elle-même, un échec presque une fois sur deux. Elle posait alors la question qui a donné à l’étude sa portée : un taux d’échec aussi élevé aurait-il été toléré s’il avait touché un autre groupe ?
Ces systèmes n’avaient pas été conçus avec l’intention de discriminer. Le problème venait, en amont, des données d’entraînement : des jeux d’images très majoritairement composés de visages clairs, sur lesquels les modèles avaient appris à être précis — au détriment de tous les visages qui s’écartaient de cette norme statistique.
LE MÊME PROBLÈME, DANS LE LANGAGE
Ce déséquilibre ne concerne pas que les visages. Il touche aussi, de manière tout aussi structurelle, les langues.
Moins de 1 % du contenu disponible sur internet est rédigé dans une langue africaine — alors que le continent représente environ un septième de la population mondiale et héberge plus de 2 000 langues. Les grands modèles de langage, entraînés majoritairement sur du texte en anglais et dans un nombre restreint de langues européennes, en héritent directement : ils comprennent et génèrent un français ou un anglais de qualité, mais peinent — ou échouent purement et simplement — face à des langues comme le wolof, le zoulou ou le swahili, en particulier lorsque ces langues combinent des structures grammaticales agglutinantes ou des pratiques de changement de code linguistique fréquentes dans les usages réels.
La conséquence dépasse le simple inconfort technique. Pour près de deux milliards de personnes dans le monde, l’absence d’outils numériques fonctionnels dans leur langue maternelle crée une barrière d’accès concrète à des services essentiels — bancaires, médicaux, administratifs — dans des régions où le mobile est souvent la principale porte d’entrée vers ces services.
📬 NDIYAM Newsletter
Cet article vous plaît ? Recevez nos prochaines explorations directement par e-mail, une fois par semaine — et un guide en cadeau de bienvenue.
DES INITIATIVES QUI CORRIGENT LE TIR DEPUIS L’AFRIQUE
Face à ce constat, des initiatives portées depuis le continent cherchent activement à combler l’écart plutôt que d’attendre qu’il se résorbe de lui-même. Masakhane, mouvement communautaire regroupant plus de 2 000 chercheurs africains en traitement automatique du langage, construit des jeux de données ouverts pour documenter et préserver une cinquantaine de langues africaines, avec l’ambition affichée de doter un milliard d’Africains d’outils d’intelligence artificielle pertinents d’ici 2029.
En Afrique du Sud, la startup Lelapa AI développe des modèles de transcription et de traduction pour l’isiZulu en utilisant des ressources de calcul délibérément réduites — une réponse directe au coût énergétique faramineux de l’entraînement des grands modèles, que sa dirigeante Pelonomi Moiloa compare à la consommation électrique mensuelle de 12 000 foyers johannesbourgeois pour un seul entraînement de modèle de type GPT. D’autres programmes, comme l’initiative FAIR Forward portée par la coopération allemande, appuient des approches locales d’intelligence artificielle au Ghana, au Kenya, au Rwanda et ailleurs.
Ces initiatives partagent un principe commun : les biais des technologies ne se corrigent pas depuis l’extérieur, par une simple bonne volonté abstraite. Ils se corrigent en construisant, depuis les communautés concernées elles-mêmes, les données et les outils qui reflètent leur réalité.
CONCLUSION
Le message de Gender Shades et des travaux qui l’ont suivi n’est pas que la technologie serait intrinsèquement malveillante. C’est qu’elle n’est jamais aussi neutre qu’elle le prétend, et que cette absence de neutralité reste, pour l’essentiel, invisible — jusqu’à ce qu’une chercheuse doive tenir un masque blanc devant sa caméra pour être enfin reconnue par une machine.
Rendre ces biais visibles, les mesurer, puis construire des alternatives depuis les communautés qu’ils excluent : c’est, très concrètement, le chantier qui occupe aujourd’hui une partie du monde de la recherche en intelligence artificielle — un chantier dans lequel l’Afrique, longtemps pensée comme simple utilisatrice de technologies conçues ailleurs, joue un rôle de plus en plus actif.
SOURCES ET POUR ALLER PLUS LOIN
L’étude de référence
Joy Buolamwini et Timnit Gebru, « Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification », Proceedings of the 1st Conference on Fairness, Accountability and Transparency (2018).
MIT News, « Study finds gender and skin-type bias in artificial-intelligence systems » (news.mit.edu, 2018).
Sur la sous-représentation des langues africaines dans l’IA
Masakhane, mouvement de recherche communautaire en traitement automatique des langues africaines (masakhane.io).
Acumen Magazine, « Building AI for African Languages » (acumenmagazine.co.za).
Frontiers in Artificial Intelligence, « AI inclusivity and the centrality of Africa: a systematic review of representation, innovation, and governance in global artificial intelligence » (2026).
Sur les initiatives de correction
Lelapa AI, travaux sur les modèles de langue sobres en ressources pour les langues sud-africaines.
FAIR Forward — Artificial Intelligence for All, initiative de la coopération allemande (GIZ).